Hướng Dẫn Tự Động Index Toàn Bộ Website Vào AI Knowledge Base Bằng URL Crawler
Khám phá cách sử dụng công cụ URL Web Crawler của TaggoAI để tự động quét toàn bộ sitemap, bóc tách nội dung bài viết và huấn luyện AI Knowledge Base chỉ trong 1 cú nhấp chuột.
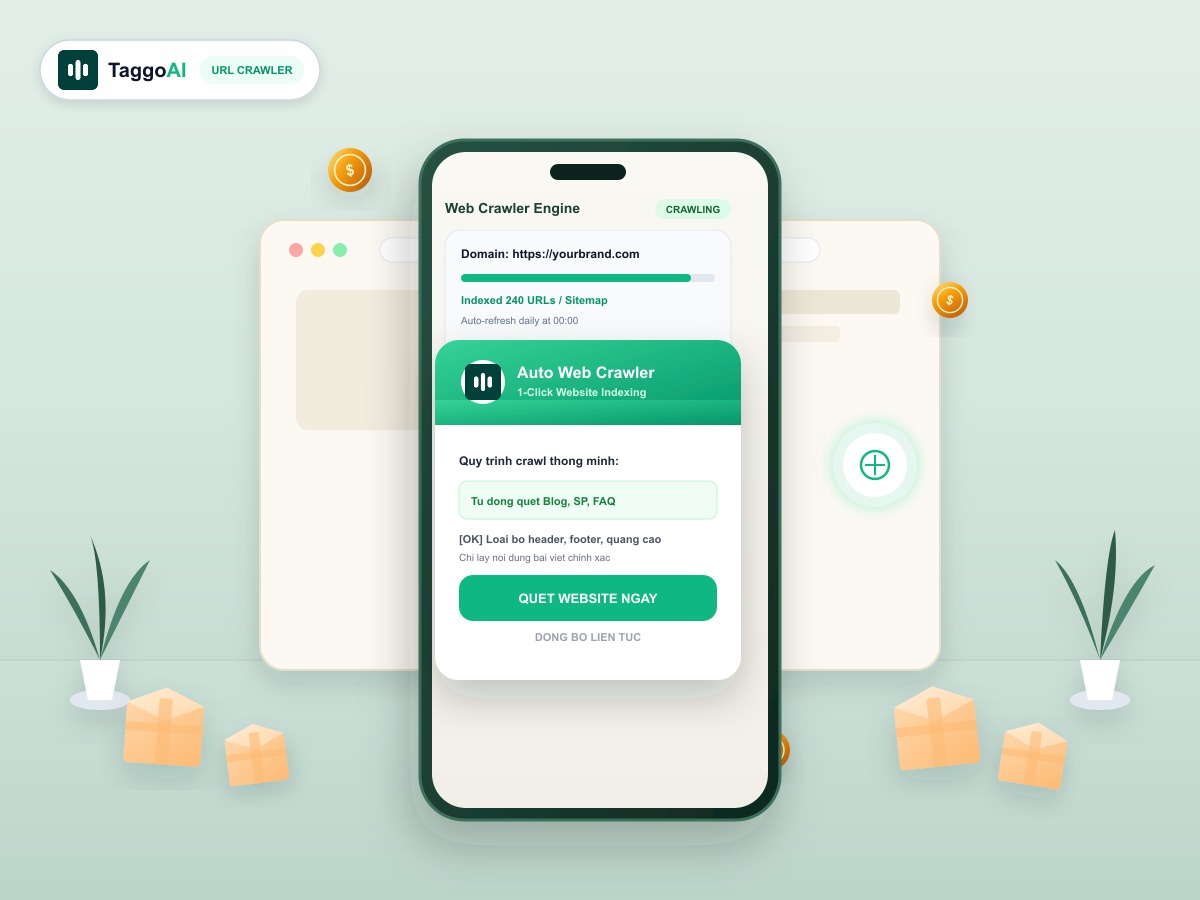
Một website doanh nghiệp thường chứa hàng trăm bài viết blog, trang giới thiệu sản phẩm và câu hỏi thường gặp (FAQ). Việc sao chép thủ công từng trang tài liệu để nạp vào AI là một cực hình tốn nhiều ngày công. Với TaggoAI URL Crawler, bạn chỉ cần nhập địa chỉ trang web hoặc đường dẫn Sitemap XML, hệ thống sẽ tự động quét, bóc tách và chuyển hóa toàn bộ nội dung thành một kho tri thức AI chuẩn xác trong vài phút.
🕷️ Công nghệ Smart Content Extraction:
Không giống các công cụ cào web thô sơ dễ lưu rác dữ liệu, thuật toán của TaggoAI tự động nhận diện cấu trúc DOM HTML, loại bỏ thanh điều hướng (Navbar), chân trang (Footer), sidebar quảng cáo và chỉ trích xuất phần nội dung cốt lõi của bài viết.
1. Các chế độ quét Website linh hoạt trên TaggoAI
🌐 Single URL Scan
Quét tức thời một đường link bài viết hoặc trang chính sách cụ thể chỉ trong 3 giây.
🗺️ Sitemap XML Crawler
Đọc toàn bộ cấu trúc sitemap để nạp đồng loạt hàng nghìn trang sản phẩm và tin tức.
🔄 Recurring Auto-Sync
Tự động kích hoạt quét lại vào 00:00 mỗi đêm để phát hiện các bài viết và sản phẩm mới xuất bản.
2. Quy trình 4 bước thiết lập Web Crawler cho AI
- Bước 1: Khai báo tên miền nguồn: Mở TaggoAI Knowledge Hub > Thêm nguồn dữ liệu > Website Crawler.
- Bước 2: Cài đặt độ sâu thu thập (Crawl Depth): Lựa chọn quét toàn bộ subdomain hoặc chỉ giới hạn trong thư mục
/blog/*và/products/*. - Bước 3: Xem trước dữ liệu bóc tách: Kiểm tra các đoạn text đã được làm sạch và xác nhận chỉ mục vector.
- Bước 4: Kết nối với AI Agent: Gán Knowledge Base cho Chatbot CSKH trên Website và Fanpage để trả lời khách hàng ngay lập tức.
Sẵn sàng nâng tầm chăm sóc khách hàng?
Tạo AI Agent thông minh cho doanh nghiệp của bạn chỉ trong vài phút.

